


Apache Spark: Transformações Avançadas e Processamento Distribuído
Quando pipelines de dados começam a consumir grandes volumes e alimentar sistemas analíticos ou aplicações, usar Spark de forma superficial deixa de ser suficiente. Profissionais passam a precisar estruturar transformações mais complexas, compreender o impacto de decisões técnicas e operar pipelines distribuídos de forma confiável.
Explore mais sobre o curso
O curso Apache Spark – Transformações Avançadas e Processamento Distribuído foi desenvolvido para profissionais que já entendem os fundamentos do Spark e precisam atuar de forma mais autônoma na construção de pipelines de dados em escala. Neste nível, o foco está no uso avançado de transformações, joins, agregações, particionamento e integração com diferentes fontes de dados, sempre considerando o impacto dessas escolhas em performance e confiabilidade. O profissional desenvolve a capacidade de tomar decisões técnicas conscientes, atuando como Data Engineer Pleno em ambientes reais.
Módulos do Curso
- Tipos de joins no Spark Joins e combinações de dados em Spark
- Custos e impactos dos joins distribuídos Joins e combinações de dados em Spark
- Erros comuns em grandes volumes de dados Joins e combinações de dados em Spark
- Partições e paralelismo Particionamento e controle de dados
- Repartition e coalesce Particionamento e controle de dados
- Distribuição eficiente de dados Particionamento e controle de dados
- Arquivos, bancos e data lakes Integração com fontes de dados
- Spark SQL Integração com fontes de dados
- Leitura incremental e escrita otimizada Integração com fontes de dados
- Monitoramento de jobs Operação e monitoramento básico
- Interpretação de falhas Operação e monitoramento básico
- Boas práticas operacionais Operação e monitoramento básico
Confira tudo que voce vai dominar neste curso.
Investimento
28 horas para transformar seus dados em vantagem competitiva.
-
 20 horas de conteúdo
-
 Certificado de conclusão
-
 Roadmap pronto
-
 Material didático com conteúdo completo
-
 Aulas prontas disponíveis por 3 meses
Garanta sua vaga na próxima turma*
Escolha a data que melhor se encaixa na sua agenda e confirme sua inscrição.
Flexibilidade online + prática presencial
Formação completa com conteúdo online e encontros práticos.
-
28 horas de conteúdo
-
Certificado de conclusão
-
Roadmap pronto
-
Material didático com conteúdo completo
-
Aulas prontas disponíveis por 3 meses
Nossas jornadas mais populares
Este curso pode fazer parte de uma ou mais jornadas, que reúnem formações relacionadas
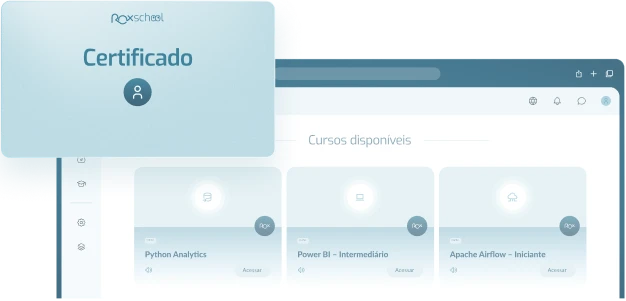
Certificado
Certificado alinhado às práticas de mercado e às plataformas utilizadas por empresas.
Outros cursos
Explore outras formações relacionadas e continue evoluindo sua jornada em dados, aprofundando conhecimentos ou expandindo para novas áreas.
Google BigQuery: Fundamentos de Big Data e SQL para Análise de Dados
Analise grandes volumes de dados com BigQuery.
Apache Spark: Fundamentos de Processamento em Escala
Processe grandes volumes de dados com Spark.
Apache Spark: Arquitetura, Performance e Otimização em Escala
Otimize performance e arquitetura do Spark.
Arquitetura de Dados em Cloud: princípios, design e governança
Domine o BigQuery, impulsione sua carreira em Data Science e aprenda a analisar com eficiência.

